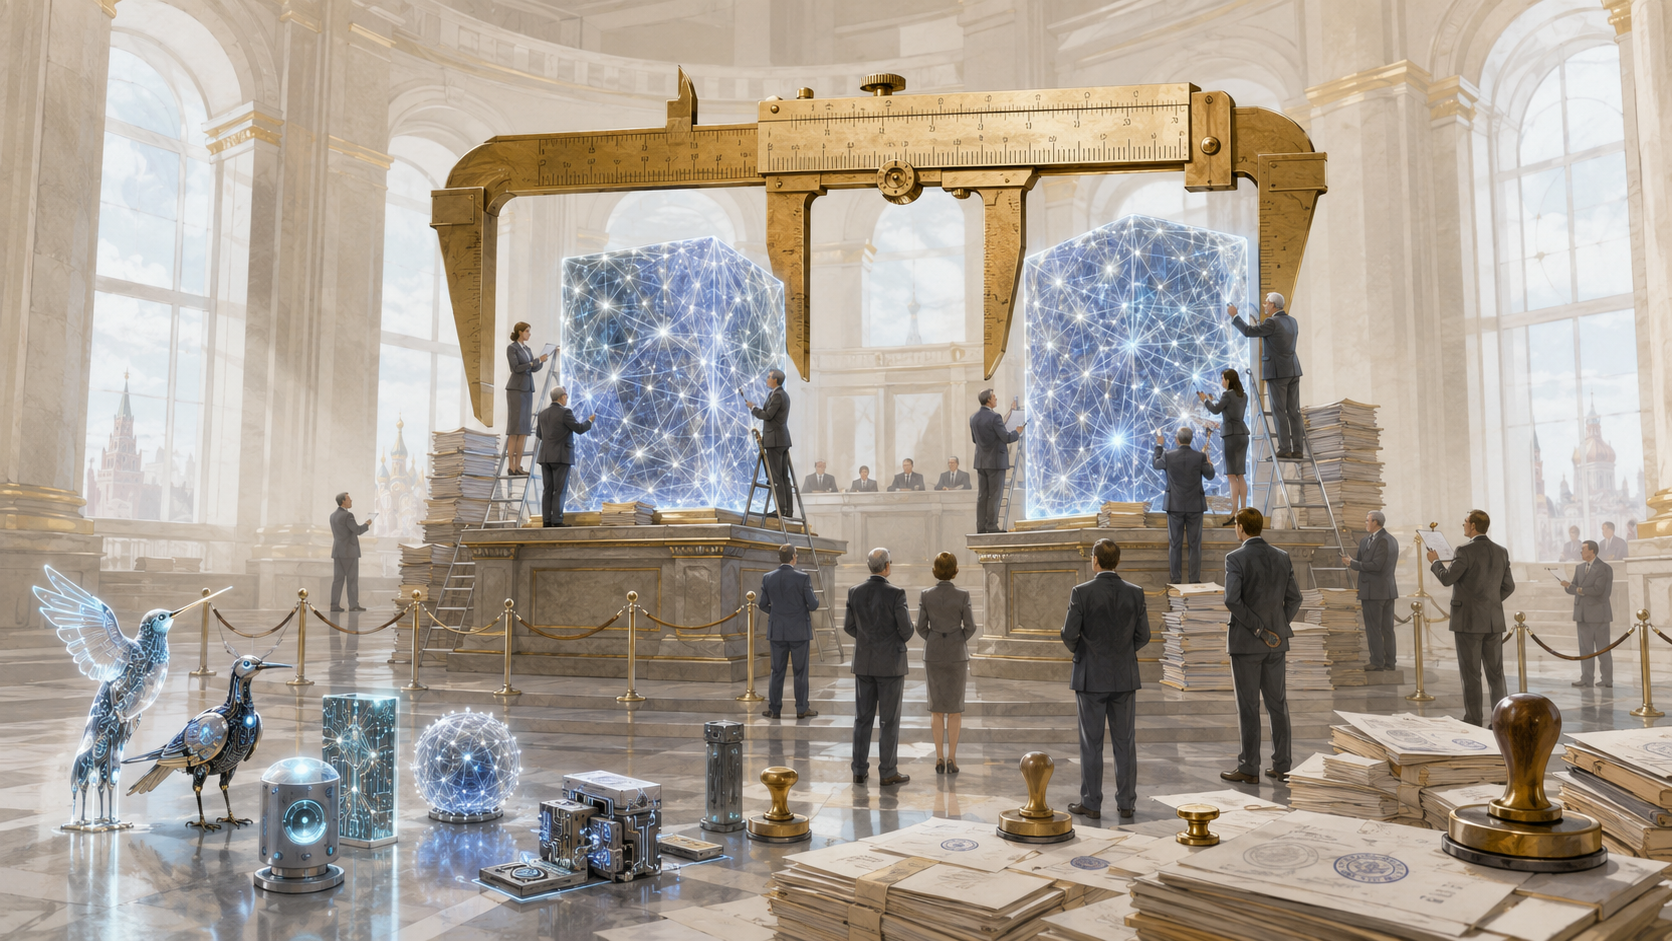

Сравнивать данные с нефтью стало настолько привычно, что за эту метафору уже хочется заранее извиниться. Тем более что в эпоху искусственного интеллекта она начинает работать всё хуже.
Нефть ценна потому, что её запасы ограничены, добыча требует денег и технологий, а современная экономика по-прежнему нуждается в ней в огромных количествах. Но один баррель определённого сорта всё-таки можно в разумных пределах заменить другим. Если один поставщик становится слишком дорогим или неудобным, начинается поиск другого месторождения, другого маршрута, другого продавца.
С данными происходит почти обратное. Многие действительно ценные массивы невозможно добыть второй раз в другом месте. Историю разговоров миллионов людей на Reddit нельзя заказать у другой компании. Многолетнюю историю покупок клиентов конкретной торговой сети нельзя заменить историей другой сети. Результаты наблюдения за физической активностью владельцев определённого фитнес-трекера существуют только у компании, которая этот трекер выпускала. Медицинская история пациента уникальна не потому, что её дорого скопировать, а потому, что второго такого пациента с точно такой же жизнью просто нет.
И по мере развития искусственного интеллекта именно эта невоспроизводимость становится всё важнее.
Когда открытого интернета начинает не хватать
Первое поколение больших языковых моделей развивалось в мире, где интернет выглядел практически неисчерпаемым источником материала. Книги, сайты, научные публикации, форумы, документация, программный код, энциклопедии, обсуждения — человечество несколько десятилетий щедро складывало в сеть всё, что знало, думало и писало.
Оказалось, что даже этот океан имеет берега.
Исследовательская организация Epoch AI оценивает эффективный запас качественного публичного текста, созданного людьми и пригодного для обучения моделей с учётом качества и повторов, примерно в 300 трлн токенов. Если прежние тенденции масштабирования сохранятся, объёмы обучающих выборок могут сравняться с этим запасом уже в период между 2026 и 2032 годами. Это не означает, что интернет внезапно «закончится»: модели могут эффективнее использовать данные, учиться на синтетических материалах, изображениях, видео, аудио и других источниках. Но эпоха, когда развитие можно было обеспечивать просто всё более широким сбором общедоступных человеческих текстов, имеет вполне заметные пределы.
При этом возникает довольно интересный экономический эффект. Публичный интернет обладает огромной общественной ценностью, но именно его общедоступность постепенно уменьшает его значение как источника конкурентного преимущества.
Если один и тот же массив книг, статей и открытых сайтов могут получить несколько разработчиков, сами по себе эти данные уже не создают уникальной позиции. Разумеется, остаются различия в архитектуре моделей, методах обучения, качестве фильтрации, вычислительных ресурсах и таланте команд. Но следующий массив данных, которого нет у конкурента, становится особенно привлекательным.
И тогда выясняется, что архив компании может стоить не меньше некоторых её традиционных активов.
Архив превращается в капитал
Эта перемена уже заметна на рынке.
В 2024 году OpenAI заключила многолетнее соглашение с News Corp, получив доступ к текущим и архивным материалам ряда принадлежащих корпорации изданий. Финансовые условия официально не раскрывались, однако стоимость сделки оценивалась более чем в 250 миллионов долларов за пять лет.
Google заключила соглашение с Reddit о предоставлении контента платформы для работы с системами искусственного интеллекта; Reuters сообщал об оценке контракта примерно в 60 миллионов долларов в год.
В 2025 году The New York Times впервые заключила лицензионное соглашение такого рода с Amazon. Оно предусматривает использование редакционных материалов издания и его других продуктов в системах искусственного интеллекта Amazon, в том числе для обучения моделей. Стороны финансовых условий сделки публично не раскрыли.
Важно здесь даже не сравнивать суммы. Формируется рынок того, что ещё несколько лет назад многие компании вообще не рассматривали как самостоятельный товар.
Редакционный архив создавался для читателей. Форум создавался для общения людей. Фитнес-приложение собирало данные, чтобы показывать человеку его пульс и количество пройденных шагов. Интернет-магазин сохранял покупки, чтобы доставлять товары, рассчитывать скидки и понимать спрос.
Теперь на всё это можно посмотреть иначе: перед нами уникальные обучающие массивы, описывающие язык, человеческое поведение, профессиональные решения, предпочтения, ошибки и реальные процессы.
ИИ превращает архив из памяти бизнеса в производственный ресурс.
И это, пожалуй, важнее знаменитой формулы «данные — новая нефть». Мы впервые получили технологию, которая способна перерабатывать колоссальные массивы накопленного человеческого опыта в работающие модели поведения и принятия решений. Поэтому значение получает уже не просто информация, а структурированная история деятельности.
У каждой компании неожиданно появилось месторождение
Это касается не только крупнейших технологических корпораций.
Практически любой работающий бизнес производит данные. Клиентские обращения, история продаж, причины отказов, результаты рекламных кампаний, внутренние документы, переговоры, решения сотрудников, ошибки, маршруты доставки, фотографии, чертежи, показатели оборудования — всё это накапливается независимо от того, считает компания себя «data-driven» или нет.
До недавнего времени значительная часть таких данных представляла интерес прежде всего для самой организации. Некоторые массивы использовались для аналитики, многие просто лежали в CRM, бухгалтерских системах, файловых хранилищах и корпоративной переписке.
С появлением ИИ вопрос меняется.
Компания должна спросить себя не только: «Какими данными мы располагаем?», но и: «Какие данные можем произвести только мы?»
Разница принципиальная.
Список российских компаний можно купить. Статистику населения можно получить из открытых источников. Большинство справочных данных существует во многих копиях.
Но история нескольких миллионов реальных диалогов службы поддержки с клиентами уже уникальна. Десять лет показателей работы конкретного типа промышленного оборудования уникальны. Связь между симптомами, назначениями и результатами лечения внутри большой медицинской системы — уникальна. Миллионы последовательностей учебных действий школьников, показывающих не только правильные ответы, но и путь к ним, также способны стать совершенно особым массивом.
Причём его ценность может быть неочевидна в момент создания.
Компания сегодня собирает данные для решения одной задачи, а через пять лет появляется технология, которая позволяет извлечь из них совершенно другую ценность.
Поэтому новая экономика данных требует довольно необычного управленческого навыка: умения замечать актив раньше, чем появился рынок, способный его оценить.
Власть принадлежит не данным, а воротам
Отсюда возникает и новая форма экономической власти.
Не обязательно владеть всеми данными мира. Более того, это невозможно. Достаточно контролировать проход к массиву, который нужен другим и не может быть полноценно заменён.
Именно поэтому отношения между владельцем уникального массива и разработчиком ИИ отличаются от обычной торговли сырьём. Если покупателю не подходит цена одного поставщика нефти, он в определённых пределах может обратиться к другому. Если разработчику нужна история Reddit, второго Reddit на рынке нет.
Конечно, это не отменяет переговоров и конкуренции. У данных существуют заменители, качество массивов различается, а синтетические данные и новые методы обучения могут уменьшать зависимость от отдельных источников. Но сама структура переговорной силы меняется: стоимость всё чаще определяется не только объёмом или затратами на создание массива, а трудностью его замещения.
Поэтому данные становятся не просто ресурсом, но и инструментом доступа.
Кто может обучаться на этом массиве? Для каких задач? На какой срок? Может ли модель сохранять полученные знания после прекращения договора? Разрешено ли создавать производные данные? Имеет ли право один разработчик получить эксклюзивность? Можно ли использовать сведения, первоначально собранные совсем для другой цели?
Вокруг этих вопросов постепенно возникает и право.
Российский Федеральный закон №243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации», подписанный 26 июля 2026 года, уже непосредственно регулирует ряд вопросов использования данных и произведений при разработке и обучении больших фундаментальных моделей. Основные нормы закона вступают в силу с 1 марта 2027 года.
Сам факт появления таких положений показателен. Вопрос доступа к обучающему материалу перестаёт быть исключительно техническим вопросом разработчика и становится вопросом экономической политики, интеллектуальной собственности и государственного регулирования.
Самое ценное может оказаться самым опасным
Есть, однако, и обратная сторона.
Чем более уникальны данные, тем чаще они одновременно являются наиболее чувствительными.
Медицинские истории ценны именно потому, что подробно описывают реальных людей. История финансовых операций ценна потому, что отражает реальное экономическое поведение. Корпоративная переписка может прекрасно показывать процесс принятия решений именно потому, что сотрудники никогда не писали её как учебник для постороннего наблюдателя.
Поэтому совет бизнесу «собирайте как можно больше данных» сегодня выглядит примерно так же разумно, как совет «храните дома как можно больше наличных, когда-нибудь пригодятся».
Каждый новый массив создаёт не только потенциальный актив, но и обязательства. Его необходимо защищать. Нужно понимать законные основания хранения и обработки. Необходимо определять, кто получает доступ и зачем. Иногда правильным решением будет сохранить данные, иногда — обезличить, иногда — агрегировать, а иногда — вообще не собирать.
ИИ делает особенно опасной привычную корпоративную фразу «пригодится для аналитики».
Теперь действительно может пригодиться.
И именно поэтому необходимо заранее понимать, какой ценой.
От владения данными — к управлению их происхождением
Следующим этапом этой экономики станет, вероятно, ещё одна перемена. Самого массива данных будет недостаточно. Всё большее значение будет иметь возможность доказать, откуда он взялся и что с ним происходило.
Кто создал данные? На каких основаниях они были получены? Изменялись ли они? Как именно очищались и объединялись? Использовался ли искусственный интеллект при их создании? Можно ли проследить версии? Существует ли подтверждаемая цепочка происхождения?
В мире, где огромные массивы синтетического и человеческого контента начинают смешиваться между собой, provenance — доказуемая история происхождения — постепенно становится отдельным свойством данных.
Это похоже на рынок искусства. Картина с понятной историей владения, документами и подтверждённым происхождением представляет собой совсем другой объект, чем похожее полотно неизвестного происхождения, найденное на чердаке. Изображение может выглядеть одинаково, но экономически и юридически это разные вещи.
С данными мы постепенно движемся к той же логике.
Качественный массив будущего — это не просто терабайты информации. Это информация, происхождение, структура, права доступа, разрешённые способы использования и подтверждаемая история изменений.
Что с этим делать
Для государства отсюда возникает политика данных. Для больших корпораций — стратегия владения массивами и доступа к ним. Для разработчиков ИИ — поиск легальных, качественных и уникальных источников обучения.
А для обычной компании вывод гораздо прозаичнее.
Стоит провести инвентаризацию не только серверов, оборудования, интеллектуальной собственности и денег на счетах, но и данных, которые организация создаёт в ходе своей обычной жизни.
Необходимо понять, какие из них общедоступны и воспроизводимы, а какие возникают только внутри конкретного бизнеса. Какие имеют потенциальную ценность для обучения и аналитики. Какие нельзя передавать вообще. Какие уже уходят внешним сервисам вместе с документами, перепиской, CRM или запросами к системам искусственного интеллекта. И, наконец, какие данные компания сейчас бездумно уничтожает, хотя через несколько лет они могли бы оказаться одним из её наиболее ценных активов.
Речь не о том, чтобы закрыть всё и перестать делиться информацией. Закрытый массив, которым невозможно законно и безопасно воспользоваться, тоже не особенно полезен.
Речь о другом: данные перестали быть цифровым мусором, остающимся после основной деятельности компании.
Они становятся частью самой деятельности.
В XX веке государства и корпорации внимательно смотрели на месторождения, транспортные коридоры, заводы и энергетические мощности. В XXI веке к этой карте постепенно добавляются совсем другие объекты: архивы, платформы, истории взаимодействий, научные базы, образовательные траектории и накопленный цифровой опыт миллионов людей.
У нефти можно найти другое месторождение.
У истории, которая уже произошла, второго месторождения нет.
И именно поэтому власть данных в эпоху искусственного интеллекта — это в конечном счёте не власть того, кто собрал больше всего информации. Это власть того, кто вовремя понял, какая информация действительно уникальна, кому она принадлежит и кто имеет право открыть к ней дверь.